我给 New API 搭了一套能回退的 CI/CD:Gitee Go、Docker 与蓝绿部署
我给 New API 搭了一套能回退的 CI/CD:Gitee Go、Docker 与蓝绿部署
YYT最开始部署 New API 时,更新一次代码就要登录服务器、停容器、拉新代码、重新构建,再把服务启动起来。偶尔改个小功能,前后折腾几分钟不算什么;线上已经有人在用时,这几分钟就不太好接受了。
我想要的不是一套看起来很复杂的发布平台,而是一个足够稳妥的流程:代码放到自己的仓库,准备好版本后点一下构建,服务器自动启动新版本,确认没问题再把流量切过去;新版本不正常时,能够尽快切回旧版本。
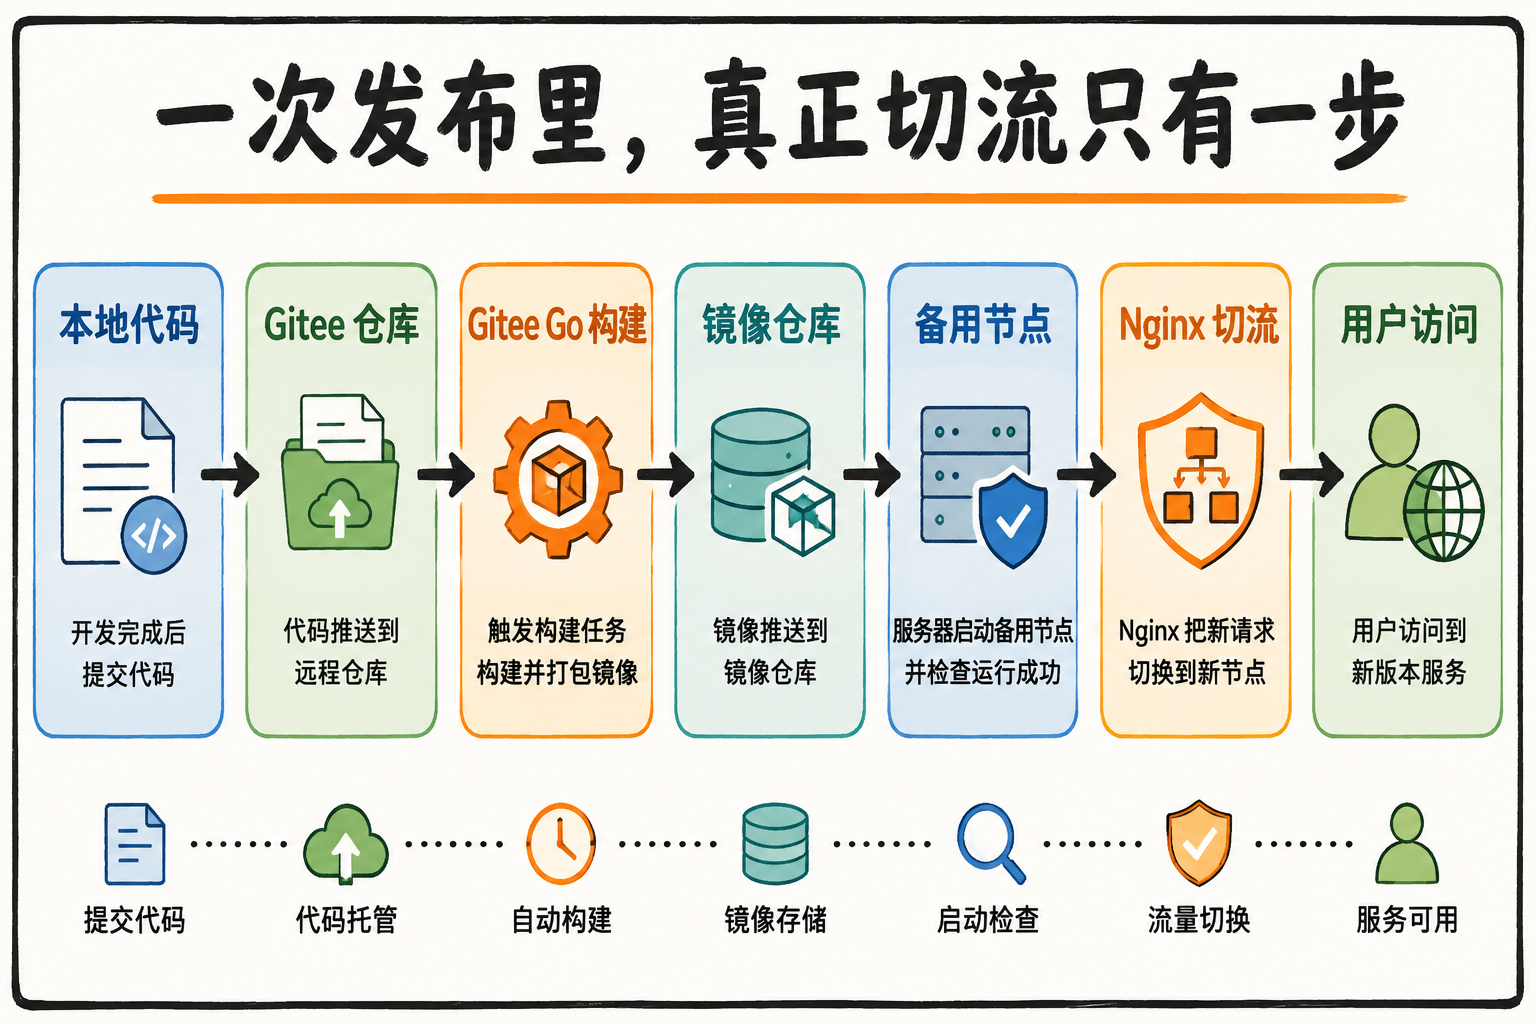
最后落地的是一套小而实用的方案:Gitee 保存代码,Gitee Go 负责流水线,Docker 镜像放在镜像仓库,运行环境是另一家云厂商的 Linux 服务器,Nginx 负责入口切换。服务器不需要和流水线在同一家云上。
图 1:一次发布从代码到线上请求的完整链路。
先把几个概念分开
这次最容易绕进去的地方,是把“源码在哪里”“镜像放在哪里”和“服务跑在哪里”当成了一件事。其实它们可以完全分开:
| 位置 | 负责什么 | 这次的选择 |
|---|---|---|
| 代码仓库 | 保存 Dockerfile、源码和流水线配置 | Gitee |
| 构建服务 | 根据代码构建镜像 | Gitee Go |
| 镜像仓库 | 保存带版本号的 Docker 镜像 | 私有镜像仓库 |
| 运行服务器 | 启动容器、提供 API | 雨云香港 Linux 服务器 |
| 流量入口 | 把域名请求转给当前节点 | Nginx |
上游项目是开源的,我没有把服务器上的容器目录误当成“源码”。正确的做法是把上游仓库拉到本地,再推到自己的 Gitee 仓库;以后更新时,从上游同步代码,检查自己的改动,再推送到自己的仓库。
这里的 Gitee 只是代码和流水线入口,服务器是不是阿里云并不影响流程。镜像仓库可以和服务器分属不同厂商,只要服务器能访问镜像仓库,流水线的 Agent 能在服务器上执行 Docker 命令即可。
为什么没有让每次 push 都自动部署
个人项目最现实的限制是构建时长。每次提交都自动构建,试验性提交、改错后的补丁也会消耗额度,而且很容易出现几条流水线排队,旧版本反过来覆盖新版本的情况。
所以我把“自动”放在了合适的位置:
- 顶层流水线触发:手动。平时 push 只更新仓库,不创建流水线。
- 构建阶段:手动。准备好一个版本后,在 Gitee Go 点一次运行。
- 蓝绿部署阶段:自动。镜像构建成功后,自动执行部署。
这样日常操作只有一个明确的发布开关:代码可以连续改很多次,准备好了再手动运行最新版本的流水线;构建通过后,部署会自动接上,不需要再点第二次。
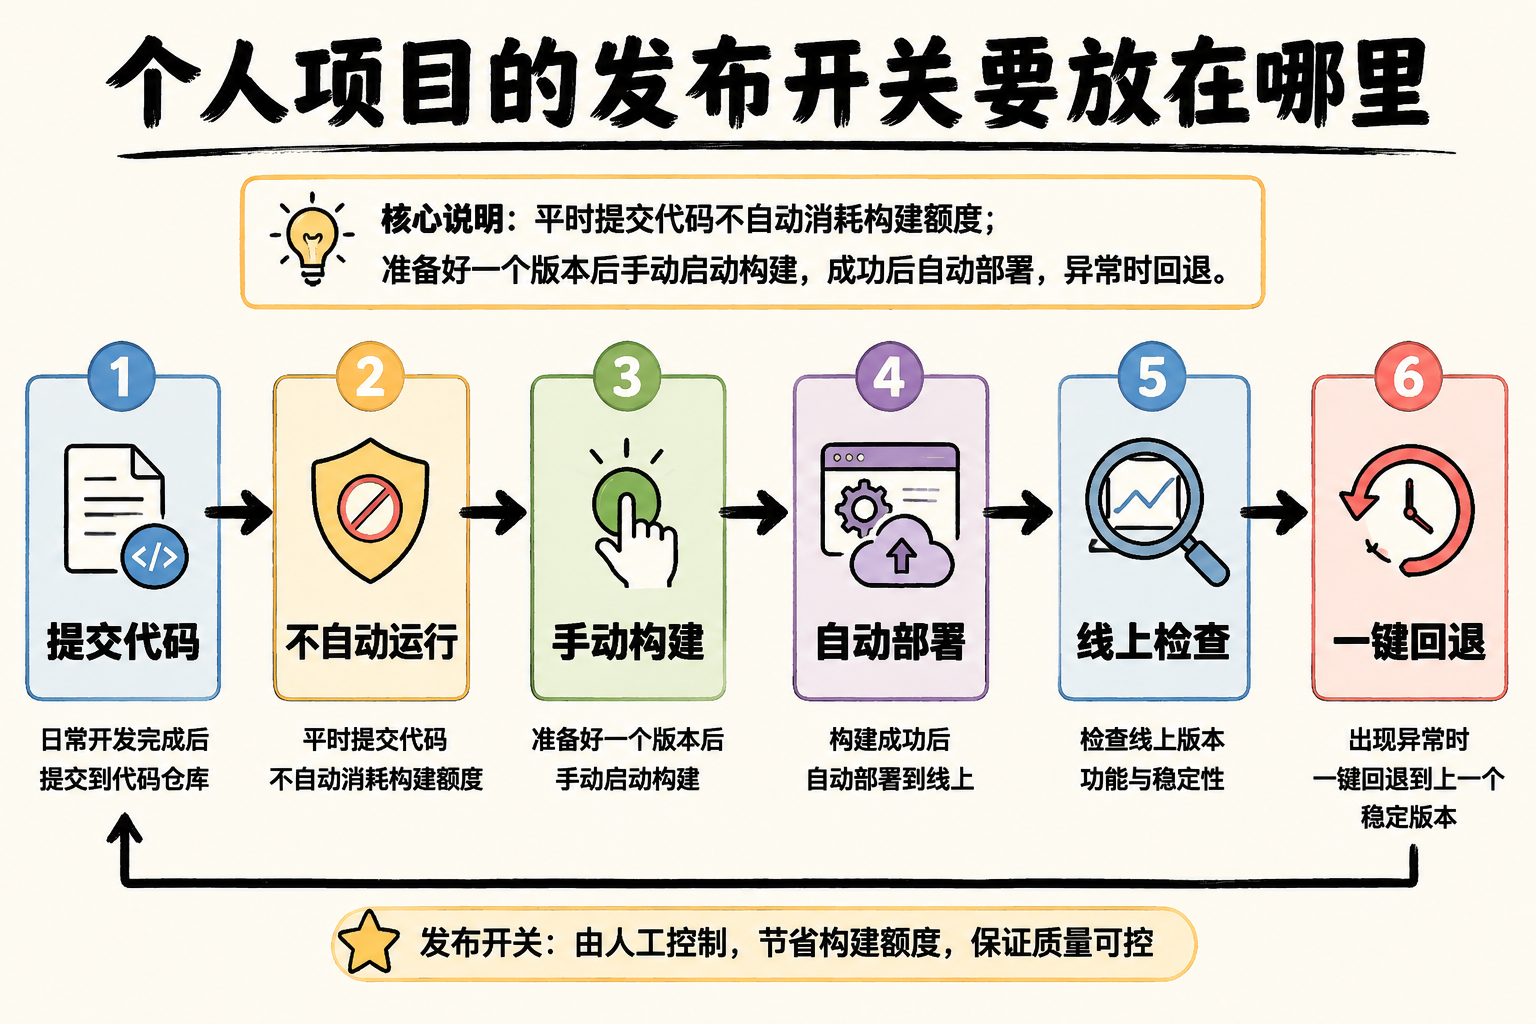
图 2:把构建保留为人工确认,把部署接在构建成功之后。
流水线的结构可以概括成下面这样。示例中的仓库地址和凭证都是占位符,不能直接照抄到生产环境:
1 | stages: |
真实配置里,镜像仓库密码、服务器登录凭证和数据库密码都应该放到 Gitee 的凭证或变量管理里。把密码直接写进 YAML,哪怕仓库是私有的,也不值得冒这个险。
蓝绿部署到底做了什么
蓝绿部署并不神秘。对单台服务器来说,就是准备两个端口、两个容器:一个承载当前流量,另一个用来启动新版本。我的两个端口示例是 13000 和 13001,它们轮流充当线上节点和备用节点。
一次发布的顺序是:
- 读取 Nginx 当前指向的端口,确定哪个是在线节点。
- 在另一个端口启动新镜像,挂载同一份运行环境和数据目录。
- 轮询新节点的
/api/status,最多等待一段时间。 - 健康检查返回成功后,修改 Nginx 的
proxy_pass,执行nginx -t,再平滑重载 Nginx。 - 通过域名再次访问健康接口,确认公网入口确实已经指向新节点。
- 等待一个短暂的宽限时间,再停止旧容器;旧容器不立即删除,方便回退。
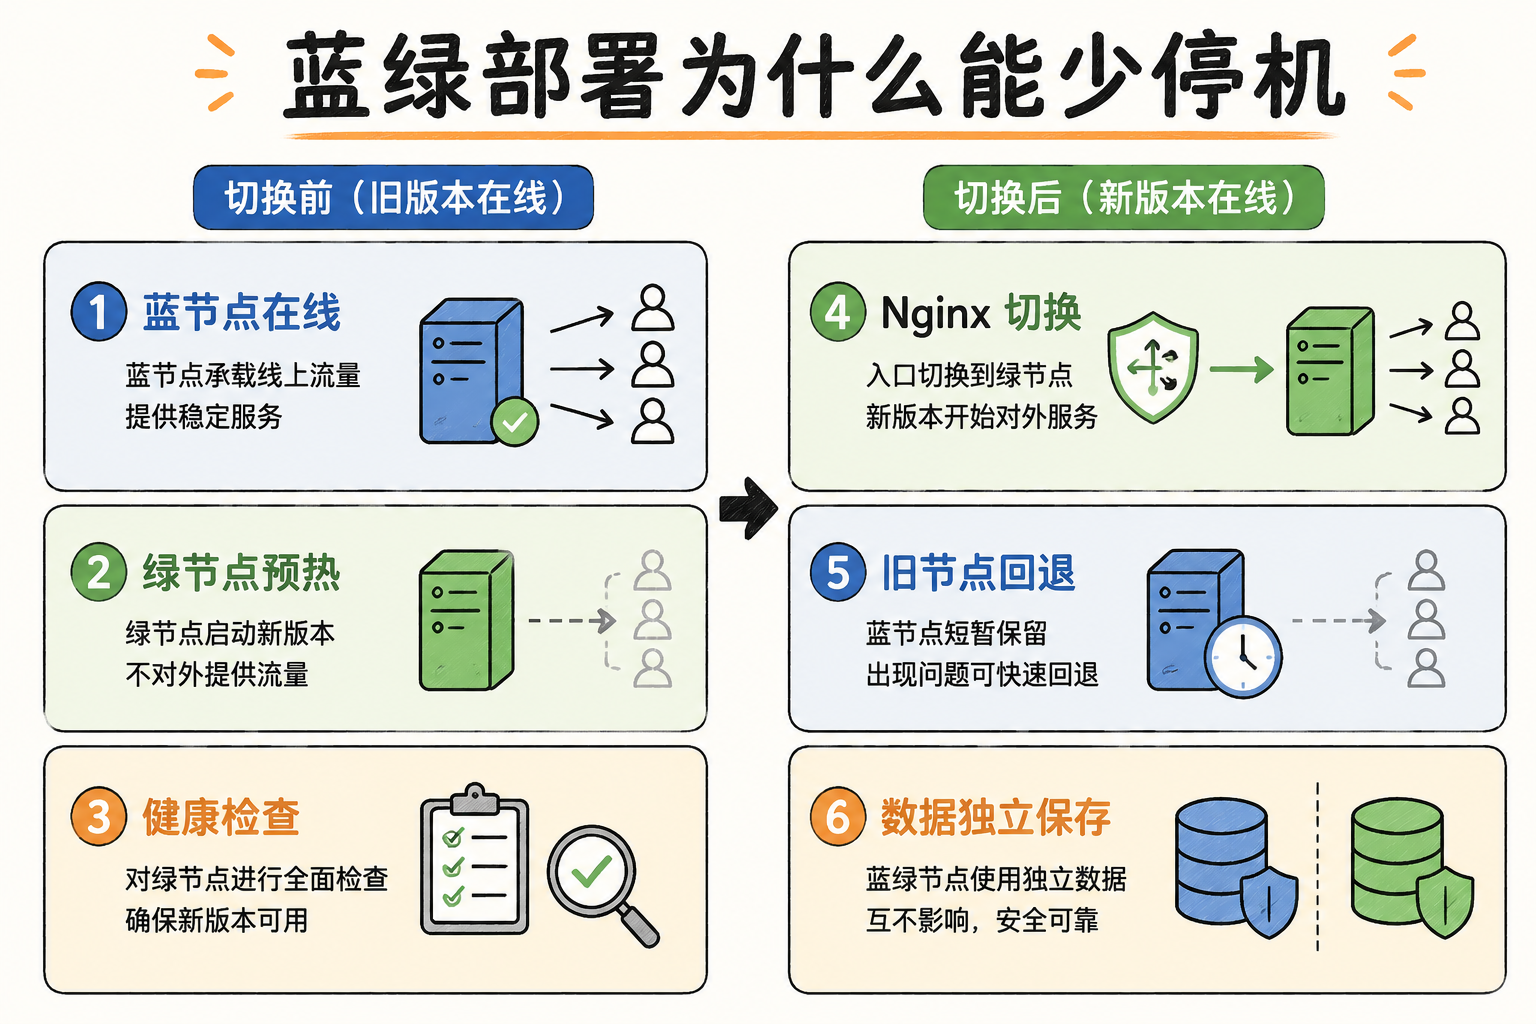
图 3:新节点先预热,入口最后切换;数据目录与版本切换分开处理。
这个顺序很重要。先停旧容器再启动新容器,只是“重启”;先启动新容器、确认新容器可用,再改入口,才有机会把中断时间压到很短。
脚本里有几条我认为必须保留的保险:
- 新节点健康检查失败,直接删除失败容器,不改 Nginx。
- Nginx 配置检查失败,恢复切换前的备份。
- 公网健康检查失败,同样恢复旧配置。
- 用锁文件防止两条流水线同时操作同一台机器。
- 数据目录、环境文件和日志目录放在容器外,不随镜像覆盖。
因此,蓝绿切换保护的是“版本替换”,不是数据库迁移。数据库结构变更仍然要单独设计兼容的迁移步骤,不能因为用了蓝绿部署就默认安全。
服务器上为什么不再拉代码
我实际遇到过一次很典型的失败:流水线任务设置了 gitClone: false,但脚本却写成了执行工作区里的 ./deploy/newapi-blue-green.sh。服务器没有源码,自然报:
1 | install: cannot stat './deploy/newapi-blue-green.sh': No such file or directory |
解决方法有两个:让任务拉取仓库,或者把部署脚本作为服务器上的固定运维文件。这里选择了后者,因为部署只需要一个镜像地址,不需要把完整源码复制到生产机。脚本预先安装到类似下面的位置:
1 | /opt/newapi/bin/newapi-blue-green.sh |
流水线只负责传入本次构建出的镜像地址,服务器脚本负责启动容器和切 Nginx。这样职责更清楚,也减少了“工作区里有没有文件”这种隐性依赖。
一次发布具体怎么走
以后我的操作顺序是:
- 在本地修改代码,先做能做的检查。
- 提交并 push 到 Gitee。这个动作不会自动部署。
- 如果还要继续改,就继续提交;不要为每一个中间版本单独发布。
- 确认要上线时,在 Gitee Go 手动运行最新流水线。
- 构建阶段把镜像打成带流水线编号的标签,例如
newapi:42,并推到私有镜像仓库。 - 构建成功后,蓝绿部署阶段自动执行。
- 打开站点做登录、接口调用和后台页面检查;有问题就回退。
版本号使用流水线编号而不是 latest,是为了知道线上到底跑的是哪一版,也避免服务器缓存了一个含义不明确的标签。每次发布都应该能从镜像标签追溯到一次构建记录。
线上有人使用时,会不会被踢下线
普通的短请求通常不会明显感觉到切换,因为旧节点在新节点通过检查之前一直在线,Nginx 重载也不会主动停止整个 Web 服务。
但它不是绝对意义上的“零影响发布”。旧容器最终还是会被停止,所以这些情况仍然可能中断:
- 正在执行很久的请求;
- 文件上传或下载;
- SSE、WebSocket 等长连接;
- 切换瞬间刚好落在旧节点上的少数请求。
当前脚本会在切流后等待几秒再停旧节点。线上有长连接时,我会把这个宽限时间调大,并尽量选低峰期发布。更稳妥的做法是让客户端对幂等请求具备重试能力,同时把数据库连接、会话和缓存放在容器外部或共享服务中。
失败时怎么处理
部署失败不应该靠“再点一次”解决,先看失败发生在哪一层:
| 失败位置 | 常见原因 | 处理方式 |
|---|---|---|
| 构建阶段 | Dockerfile、依赖或网络问题 | 修复构建日志里的具体错误,再重新运行 |
| 拉取镜像 | 镜像仓库权限、网络或标签错误 | 检查凭证和本次流水线编号 |
| 新节点健康检查 | 环境变量、端口或应用启动失败 | 查看备用容器日志,线上入口不会被切换 |
| Nginx 检查 | 配置语法或路径错误 | 脚本会恢复备份,修复配置后再试 |
| 公网检查 | 域名、证书或反向代理问题 | 保留旧入口,先恢复网络配置 |
如果新版本已经切过去,但功能验证发现问题,可以使用服务器上预装脚本的回退动作。示意命令如下,实际路径按自己的服务器配置替换:
1 | bash /opt/newapi/bin/newapi-blue-green.sh --check |
--check 只做当前节点和公网健康检查;--rollback 会把备用节点重新启动(如果需要),检查通过后把 Nginx 切回去。回退依赖旧容器和旧镜像仍然存在,所以不要在验证完成前立刻清理所有旧版本。
凭证和脱敏,别等出事才补
这篇文章里的 IP、域名、仓库路径、主机 ID、用户名、密码和 Token 都是脱敏后的占位符。生产环境至少要做到下面几件事:
- YAML 只引用凭证,不写明文密码。
- 服务器私钥和数据库密码不提交到代码仓库。
- 镜像仓库使用最小权限账号,并定期轮换密码。
- 日志里不要打印完整的 Token、Cookie 或
runtime.env。 - 线上服务器只开放必要端口,Docker 和 Nginx 及时更新。
- 回退脚本和 Nginx 配置备份也要限制文件权限。
尤其不要因为“仓库是私有的”就把密码写进去。私有仓库解决的是可见性,不是凭证泄露后的影响范围。
这套方案适合谁
它适合单机、小团队和个人项目:不需要先上 Kubernetes,也不要求服务器必须是某一家云厂商的产品;只要有一台能跑 Docker 的 Linux 服务器,就能把发布过程固定下来。
它也有边界:只有一台服务器时,机器本身宕机仍然没有真正的高可用;蓝绿节点共用同一台机器,资源紧张时构建和启动新容器会争抢 CPU、内存;数据库迁移、定时任务、队列消费者还需要额外处理。
对我来说,这个取舍是可以接受的。它先解决了最烦的那件事——每次更新都要手动停服务——同时保留了清晰的版本号、健康检查和回退入口。等项目规模真的需要多机高可用,再把这套发布逻辑迁移到更完整的平台也不迟。
最后把流程压缩成一句话:代码平时正常提交,发布时手动打开构建开关;新镜像在备用节点完成自检,Nginx 最后切流,出问题就切回旧节点。对于个人项目,这已经是一条足够可靠、也足够容易维护的 CI/CD 起点。