GPT-5.6 Sol 的 1M 上下文怎么开?
GPT-5.6 Sol 的 1M 上下文怎么开?
YYT2026 年 8 月 17 日,我看到 Tibo Sottiaux 在 X 上发了一组 Codex 配置:选择 gpt-5.6-sol,把上下文预算设为 100 万 Token,并在 90 万 Token 左右开始压缩旧历史。
帖子里有两个数字需要分开看。OpenAI 官方模型页列出的 GPT-5.6 Sol 上下文窗口是 1,050,000 Token,Tibo 写进 Codex 的预算是 1,000,000 Token。这组设置针对 Codex 客户端,不是 chatgpt.com 的设置,也不能直接套到其他 GPT-5.6 型号上。
Tibo 的原帖到底说了什么?
我把原帖的核心部分截在下面,方便和配置逐项对照。Tibo 的公开账号简介写的是 “Codex & ChatGPT @OpenAI”。
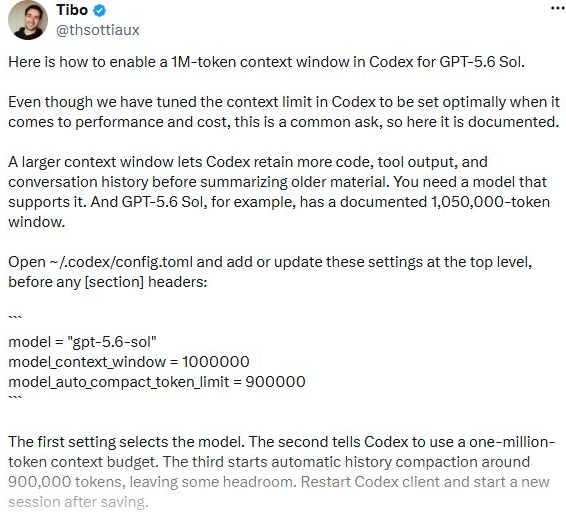
图 1:Tibo 原帖的核心部分,完整内容和一次性 CLI 命令可以点开原帖查看。
帖子主要说了五件事:
- GPT-5.6 Sol 的官方模型规格支持 1,050,000 Token 上下文窗口。
- Codex 的默认上下文限制经过了性能和成本调优,默认不开到最大值。
- 用户可以在
~/.codex/config.toml中主动把 Codex 上下文预算改为 1,000,000 Token。 model_auto_compact_token_limit = 900000会让 Codex 在约 90 万 Token 时开始压缩旧历史,为后续代码、工具输出和回答留出余量。- 保存后需要重启 Codex,并新建会话;旧会话不会自动切换到新预算。
放在一起看,就是 GPT-5.6 Sol 的模型窗口约为 1.05M Token,Codex 可以按 1M Token 使用,并在接近 900K 时提前整理旧内容。
1.05M、1M、900K 为什么不一样?
这三个数字分别来自模型规格和 Codex 配置,含义并不相同。
| 数字 | 所在层级 | 实际含义 |
|---|---|---|
| 1,050,000 | GPT-5.6 Sol 模型规格 | OpenAI 官方模型页公布的上下文窗口上限 |
| 1,000,000 | Codex 客户端配置 | 告诉 Codex 最多按 100 万 Token 的上下文预算工作 |
| 900,000 | Codex 自动压缩阈值 | 历史接近 90 万 Token 时开始总结旧内容,避免顶到窗口边缘 |
图 2:900K 是压缩起点,1M 是 Codex 预算,1.05M 是模型文档上限。图中余量是运行缓冲,不应理解为独立、保证可用的输出额度。
我不建议把配置直接写成 1050000。Codex 运行时除了聊天文字,还会加入工具定义、代码片段、命令输出、图片信息和模型回答。预算贴着模型上限时,下一次工具返回就可能把请求推到边界。100 万预算和 90 万压缩线,正好给后面的运行过程留了一段余量。
自动压缩也不是清空会话。Codex 会把较早的过程整理成更短的摘要,再带着摘要继续工作。摘要会丢掉一部分细节,所以 1M 只是让压缩发生得更晚。
怎样在 Codex 中开启 1M 上下文?
第一步:确认你使用的是 GPT-5.6 Sol
先在 Codex 的模型列表里确认能看到 gpt-5.6-sol。配置文件只能选择账号已经可以使用的模型,不能绕过账号权限、地区限制和用量限制。
如果列表里没有 GPT-5.6 Sol,可以先更新 Codex 并重新检查账号;直接把模型名写进配置文件也不会获得访问权限。
第二步:打开 config.toml
Codex 的用户级配置文件位于 .codex 目录:
| 系统 | 配置路径 |
|---|---|
| Windows | C:\Users\你的用户名\.codex\config.toml |
| macOS | /Users/你的用户名/.codex/config.toml |
| Linux | /home/你的用户名/.codex/config.toml |
Windows PowerShell 可以直接打开:
1 | notepad "$env:USERPROFILE\.codex\config.toml" |
macOS 或 Linux 可以用自己习惯的编辑器打开:
1 | nano ~/.codex/config.toml |
第三步:把三项配置写在顶层
按照原帖,在任何 [section] 标题之前加入或更新下面三项:
1 | model = "gpt-5.6-sol" |
三项设置的作用分别是:
model:选择 GPT-5.6 Sol;model_context_window:把 Codex 的上下文预算设为 100 万 Token;model_auto_compact_token_limit:上下文接近 90 万 Token 时开始自动压缩旧历史。
这里最容易写错的是位置。TOML 的表头会改变后续字段的归属,下面这样写会把配置放进 features 表:
1 | [features] |
如果文件里已经有同名字段,直接修改原值即可。再写一份会触发 TOML 重复键错误。
第四步:重启并新建会话
保存配置后,要完全退出 Codex 再重新打开,并创建一个新会话。对于 CLI,就是退出当前 TUI 后重新运行 codex。Tibo 原帖里也明确写了 “restart Codex client and start a new session”。
已经打开的会话仍可能沿用原来的模型和预算,所以不要用旧会话判断配置有没有生效。
图 3:从模型权限到新会话的完整生效过程。
只想临时试一次,怎样不改默认配置?
如果只想试一次,可以用 Tibo 给出的 CLI 参数。下面把多行命令合并成一行,PowerShell、CMD、Bash 和 zsh 都能直接执行:
1 | codex -m gpt-5.6-sol -c model_context_window=1000000 -c model_auto_compact_token_limit=900000 |
这里的 -c 只覆盖本次 CLI 会话,不会改动 config.toml。我第一次试这类配置时会先用临时参数,跑完一个真实任务,再决定要不要改成全局默认值。
怎样确认配置已经被读取?
我会检查下面几项:
- 新会话顶部或模型选择器显示的模型应当是
gpt-5.6-sol。 - 如果当前版本的 Codex 显示上下文计数或上下文比例,新的会话应按扩大的预算计算。
- 新版 Codex CLI 可以运行
codex doctor --summary,确认配置文件能够正常加载。它能检查配置语法,但不能替代服务端模型权限检查。 - 如果客户端提示未知配置项或未知模型,先升级 Codex;如果提示无权使用模型,则需要等待账号开放或改回可用模型。
配置文件能正常加载,只能说明语法没有问题。服务端是否允许 1M,还要看新会话中的模型信息、上下文指示和实际运行状态。
这是不是 ChatGPT 网页端的 1M 开关?
这里最容易混淆。Tibo 说的是 Codex 客户端,配置文件也是 Codex 的 ~/.codex/config.toml。修改它不会让 chatgpt.com 的普通聊天页面多出一个 1M 选项。
ChatGPT 账号可能被用于登录 Codex,但“用 ChatGPT 账号登录 Codex”和“修改 ChatGPT 网页聊天的上下文”是两件事。这个配置也不会把 ChatGPT 订阅额度变成 API 余额,更不会绕过套餐的速率或用量限制。
帖子明确写的是 GPT-5.6 Sol。Terra、Luna 或其他型号能否使用相同窗口,需要分别看它们自己的模型规格。
开到 1M 后,会不会每轮都消耗 100 万 Token?
不会按 100 万 Token 固定消耗。model_context_window = 1000000 设置的是可用预算上限,不是每轮请求的固定长度。
新会话仍然可能只有几千 Token。Codex 读取代码、执行命令、接收日志并继续对话后,上下文才会慢慢增长。任务足够长时,1M 窗口才会用得上。
窗口变大后,用量和速度要留意这几件事:
- 通过 API Key 按 Token 计费时,超长输入可能显著增加费用;
- 通过 ChatGPT 账号使用 Codex 时,超长任务也可能更快消耗套餐用量;
- 重复携带大量工具输出会增加首 Token 延迟;
- 无关历史过多时,模型可能被旧代码、失败日志和过时结论干扰;
- Prompt Caching 能降低重复前缀的部分计算成本,但不能让 1M 上下文变成免费。
关于缓存和长对话费用的底层逻辑,可以继续看站内的《大模型的上下文缓存是什么?》。
哪些任务值得使用 1M?
我会把 1M 留给长周期、跨文件、工具输出很多的任务,例如:
- 大型单体仓库或 Monorepo 的跨模块重构;
- 持续数小时甚至数天的排障和迁移;
- 需要对照大量接口、测试、日志和历史决策的任务;
- 大范围代码审查、依赖升级和架构梳理;
- 一个会话中连续完成调研、实现、测试和文档交付。
普通的单文件修改、小 Bug、短问答,用不到这么大的窗口。更晚压缩还会让无关日志和旧代码留得更久。Tibo 在帖子最后特意写了一句 “we tuned the default carefully”,默认值仍然是日常使用更均衡的选择。
我的实际用法是:日常任务保留默认值,大仓库重构或长时间排障再开 1M。只是想看看效果,就用一次性 CLI 参数,不改全局配置。
常见问题排查
修改后完全没有变化
先看字段是否放在第一个 [section] 之前,然后确认客户端已经彻底重启,并且使用的是新会话。写进 [features] 下面或者继续使用旧会话,都会看起来像配置没有生效。
config.toml 报重复键
搜索 model、model_context_window 和 model_auto_compact_token_limit,每个顶层字段只保留一份。不要在文件开头和文件末尾各写一次。
提示找不到 gpt-5.6-sol
一般是客户端版本或账号权限还没匹配。更新客户端、重新登录并检查模型列表;仍然不可用,就先恢复原来的模型配置。
还没到 90 万就发生压缩
先确认是不是旧会话。除此之外,Codex 也可能为了给工具结果和回答留空间而提前整理上下文,900000 更适合看作触发线,而不是精确到单个 Token 的承诺。
最终结论
看完原帖,事情其实不复杂:GPT-5.6 Sol 的官方窗口约为 1.05M,Codex 可以把预算设成 1M,并在 900K 左右开始压缩旧历史。
配置只有三行,但边界要分清:它只对支持该窗口的模型和 Codex 新会话生效,不修改 ChatGPT 网页端,也不会消除长上下文带来的成本和延迟。大型代码库、长时间排障可以试 1M,普通开发继续用默认值就够了。
资料来源
- Tibo Sottiaux:How to enable a 1M-token context window in Codex for GPT-5.6 Sol
- OpenAI Docs:GPT-5.6 Sol Model
- OpenAI Docs:Codex Configuration Reference
- OpenAI Docs:Codex Sample Configuration
本文资料核验时间:2026 年 8 月 18 日。模型权限、套餐限制和 Codex 默认值可能随版本与灰度发布变化,请以 OpenAI 官方文档和当前客户端为准。